|
|
HA 的 recorder 不適合存長期數據。
想看「過去兩年的用電趨勢」,要把資料搬出去。
為什麼不用 HA 自己存
- recorder 的設計是「最近的詳細狀態」,不是時序資料庫
- purge_keep_days 一過就刪掉
- SQLite 查大量歷史資料很慢
- HA 的歷史圖表功能有限(不能疊圖、不能做複雜計算)
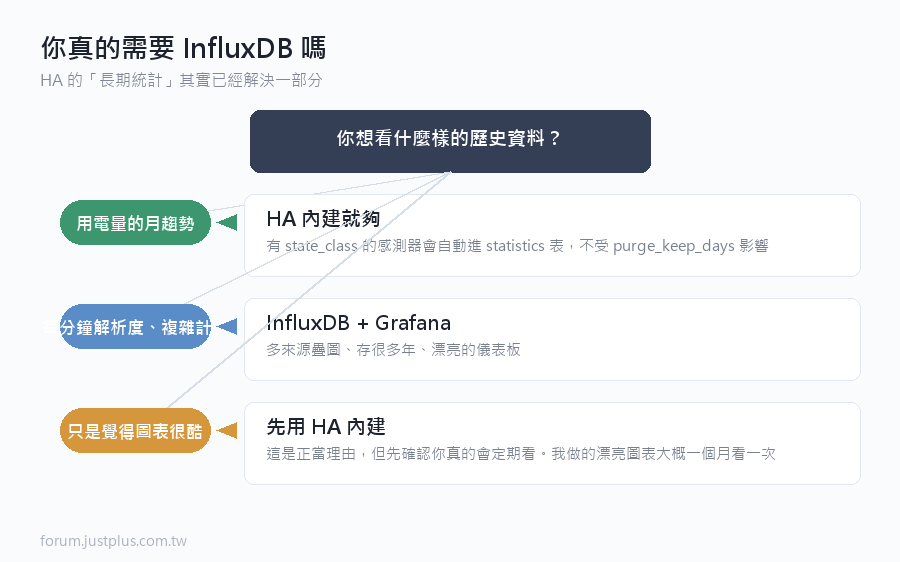
HA 的「長期統計」其實已經解決一部分
先講清楚:有 state_class 的感測器會自動進 statistics 表,
每小時存一筆(最大/最小/平均),而且不受 purge_keep_days 影響。
所以如果你只是想看「用電量的月趨勢」,HA 內建就夠了。
什麼時候才需要 InfluxDB + Grafana:
- 要更細的解析度(每分鐘而不是每小時)
- 要複雜的查詢和計算
- 要把多個來源的資料疊在一起看
- 要漂亮的儀表板(Grafana 真的比較好看)
- 要存很多年
架設 InfluxDB
用前面那篇的 compose 檔就可以。重點設定:
- influxdb:
- image: influxdb:2
- container_name: influxdb
- restart: unless-stopped
- ports:
- - "8086:8086"
- volumes:
- - /volume1/docker/influxdb/data:/var/lib/influxdb2
- - /volume1/docker/influxdb/config:/etc/influxdb2
- environment:
- - TZ=Asia/Taipei
- - DOCKER_INFLUXDB_INIT_MODE=setup
- - DOCKER_INFLUXDB_INIT_USERNAME=admin
- - DOCKER_INFLUXDB_INIT_PASSWORD_FILE=/run/secrets/influx_pw
- - DOCKER_INFLUXDB_INIT_ORG=home
- - DOCKER_INFLUXDB_INIT_BUCKET=homeassistant
- - DOCKER_INFLUXDB_INIT_RETENTION=520w # 十年
起來之後到 http://NAS:8086,用 admin 登入。
建立一個專用的 API Token:
Load Data → API Tokens → Generate API Token → Custom API Token
- 對 homeassistant bucket 給 Read + Write
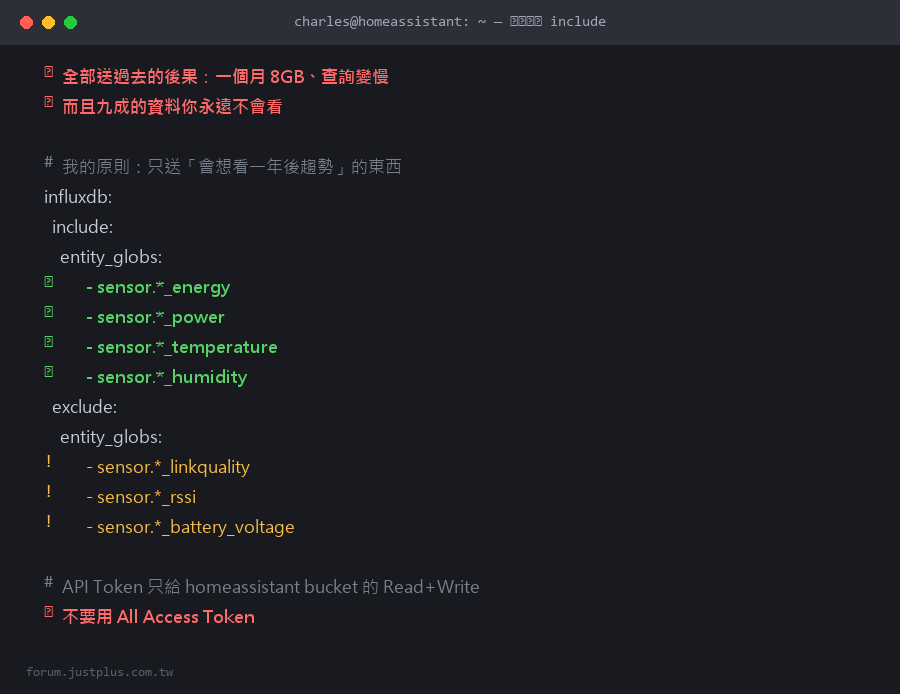
- 不要用 All Access Token
- 產生後馬上複製(只顯示一次)
HA 這邊的設定
- # configuration.yaml
- influxdb:
- api_version: 2
- ssl: false
- host: 192.168.1.20
- port: 8086
- token: !secret influxdb_token
- organization: home
- bucket: homeassistant
- tags:
- source: ha
- tags_attributes:
- - friendly_name
- - device_class
- default_measurement: units
- # 關鍵:只送你真的要長期保存的
- include:
- domains:
- - sensor
- entity_globs:
- - sensor.*_energy
- - sensor.*_power
- - sensor.*_temperature
- - sensor.*_humidity
- entities:
- - binary_sensor.front_door
- - climate.living_room
- exclude:
- entity_globs:
- - sensor.*_linkquality
- - sensor.*_rssi
- - sensor.*_battery_voltage
- - sensor.*_last_seen
- - sensor.date*
- - sensor.time*
一定要用 include,不要全部送。
全部送的後果:
- InfluxDB 長得很快(我試過一個月 8GB)
- 網路流量增加
- 查詢變慢
- 而且九成的資料你永遠不會看
我的原則:只送「會想看一年後趨勢」的東西。
實際上大概是:溫度、濕度、用電量、功率、CO2、PM2.5。
驗證有沒有進去
- # 在 InfluxDB 的 Data Explorer 裡
- from(bucket: "homeassistant")
- |> range(start: -1h)
- |> filter(fn: (r) => r["_measurement"] == "°C")
- |> filter(fn: (r) => r["entity_id"] == "living_room_temperature")
注意:HA 送過去的 measurement 名稱是「單位」
(°C、%、W、kWh),這是預設行為。
想改成用實體名當 measurement:
- influxdb:
- override_measurement: state
但改了之後查詢語法會不一樣,而且已經存的資料不會變。
一開始就決定好,不要中途改。
Grafana 設定
第一步:加資料來源
Connections → Add new connection → InfluxDB
- Query Language:Flux(InfluxDB 2.x 用這個)
- URL:http://influxdb:8086(同一個 compose 網路的話用容器名)
- Organization:home
- Token:剛剛那個
- Default Bucket:homeassistant
第二步:做第一個圖表
- from(bucket: "homeassistant")
- |> range(start: v.timeRangeStart, stop: v.timeRangeStop)
- |> filter(fn: (r) => r["_measurement"] == "°C")
- |> filter(fn: (r) => r["_field"] == "value")
- |> filter(fn: (r) => r["entity_id"] =~ /.*_temperature/)
- |> aggregateWindow(every: v.windowPeriod, fn: mean, createEmpty: false)
- |> yield(name: "mean")
幾個實用的查詢
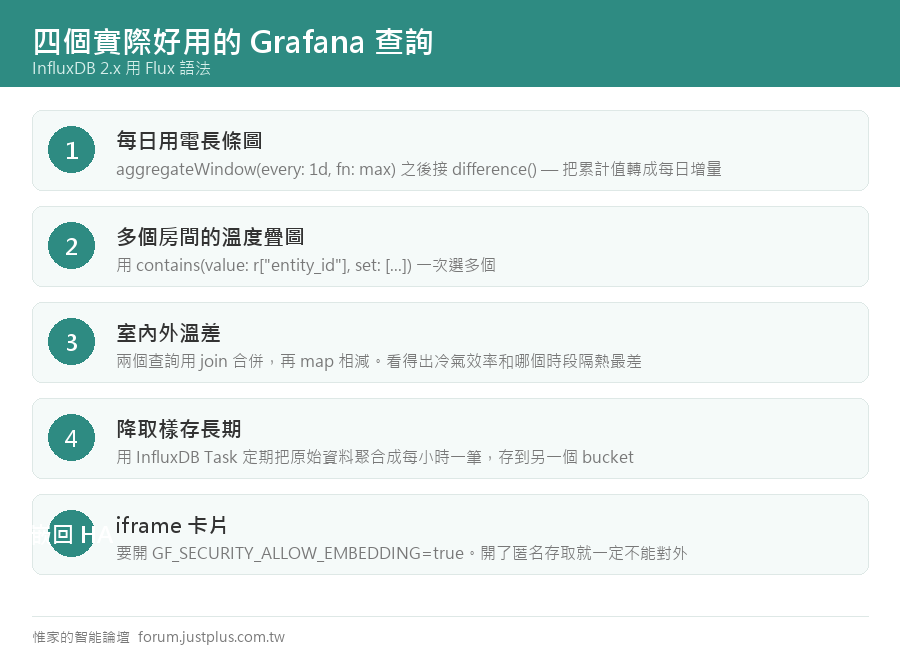
每日用電量(長條圖):
- from(bucket: "homeassistant")
- |> range(start: -30d)
- |> filter(fn: (r) => r["entity_id"] == "total_energy")
- |> filter(fn: (r) => r["_field"] == "value")
- |> aggregateWindow(every: 1d, fn: max, createEmpty: false)
- |> difference()
用 difference() 把「累計值」轉成「每日增量」,
這是累計型感測器最常用的處理。
多個房間的溫度疊圖:
- from(bucket: "homeassistant")
- |> range(start: v.timeRangeStart, stop: v.timeRangeStop)
- |> filter(fn: (r) => r["_measurement"] == "°C")
- |> filter(fn: (r) => contains(value: r["entity_id"],
- set: ["living_room_temperature",
- "bedroom_temperature",
- "study_temperature"]))
- |> aggregateWindow(every: v.windowPeriod, fn: mean, createEmpty: false)
室內外溫差:
- indoor = from(bucket: "homeassistant")
- |> range(start: v.timeRangeStart, stop: v.timeRangeStop)
- |> filter(fn: (r) => r["entity_id"] == "living_room_temperature")
- |> filter(fn: (r) => r["_field"] == "value")
- |> aggregateWindow(every: 10m, fn: mean)
- outdoor = from(bucket: "homeassistant")
- |> range(start: v.timeRangeStart, stop: v.timeRangeStop)
- |> filter(fn: (r) => r["entity_id"] == "outdoor_temperature")
- |> filter(fn: (r) => r["_field"] == "value")
- |> aggregateWindow(every: 10m, fn: mean)
- join(tables: {i: indoor, o: outdoor}, on: ["_time"])
- |> map(fn: (r) => ({ _time: r._time, _value: r._value_i - r._value_o }))
這個圖很有意思 —— 可以看出冷氣的實際效率,
以及哪些時段隔熱最差。
把 Grafana 嵌回 HA
- # 儀表板 YAML
- type: iframe
- url: >
- http://192.168.1.20:3000/d-solo/abc123/home?orgId=1&panelId=2&kiosk&theme=dark
- aspect_ratio: 50%
要先在 Grafana 允許嵌入:
- environment:
- - GF_SECURITY_ALLOW_EMBEDDING=true
- - GF_AUTH_ANONYMOUS_ENABLED=true
- - GF_AUTH_ANONYMOUS_ORG_ROLE=Viewer
開了匿名存取的話,一定要確認 Grafana 沒有對外開放。
維運注意事項
1. 磁碟會長
設定保留期限(Retention Policy):
Load Data → Buckets → 點那個 bucket → Settings → Retention
我的設定:
- 原始資料保留 90 天
- 另外建一個 bucket 存降取樣的資料,保留 十年
降取樣(Downsampling):用 InfluxDB 的 Task 定期把
原始資料聚合成每小時一筆,存到另一個 bucket。
- // InfluxDB Task
- option task = {name: "downsample_hourly", every: 1h}
- from(bucket: "homeassistant")
- |> range(start: -2h)
- |> filter(fn: (r) => r["_field"] == "value")
- |> aggregateWindow(every: 1h, fn: mean, createEmpty: false)
- |> to(bucket: "homeassistant_long", org: "home")
2. 備份
- docker exec influxdb influx backup /tmp/backup \
- -t 你的token
- docker cp influxdb:/tmp/backup /volume1/backup/influx-$(date +%F)
Grafana 的儀表板也要備份:
可以用 Export JSON,存進 Git。
3. 時區
- 容器要設 TZ=Asia/Taipei
- Grafana 的使用者偏好也要設時區
- 不然圖表的 X 軸會差 8 小時
---
老實講,這一套對大多數人來說是過度工程。
如果你只是想看用電趨勢,HA 內建的能源儀表板就很夠了。
值得裝 InfluxDB + Grafana 的情況:
- 你真的會定期看數據做決策
- 你想要很細的解析度
- 你喜歡做圖表(這是正當理由)
我自己裝了之後,最常看的其實只有兩張圖:
每日用電長條圖和室內外溫差。
其他做得很漂亮的圖表,大概一個月看一次。 |
|




 窺視卡
 雷達卡


 發表於
 提升卡
 置頂卡
 沉默卡
 喧囂卡
 變色卡
 千斤頂
 照妖鏡