找回密碼
 立即註冊
惟家LINE群QRCODE
    查看: 0|回覆: 0

    讓本地 LLM 控制你家:選模型、控制範圍、避免它亂來

    [複製鏈接]

    !lvup!   100%

    363

    主題

    27

    回帖

    2200萬

    積分

    管理員

    積分
    22005752
    發表於 3 天前 | 顯示全部樓層 |閱讀模式
    上一篇把語音助理跑起來了。

    這篇講「加上 AI」之後的事 —— 包括它會怎麼出錯。


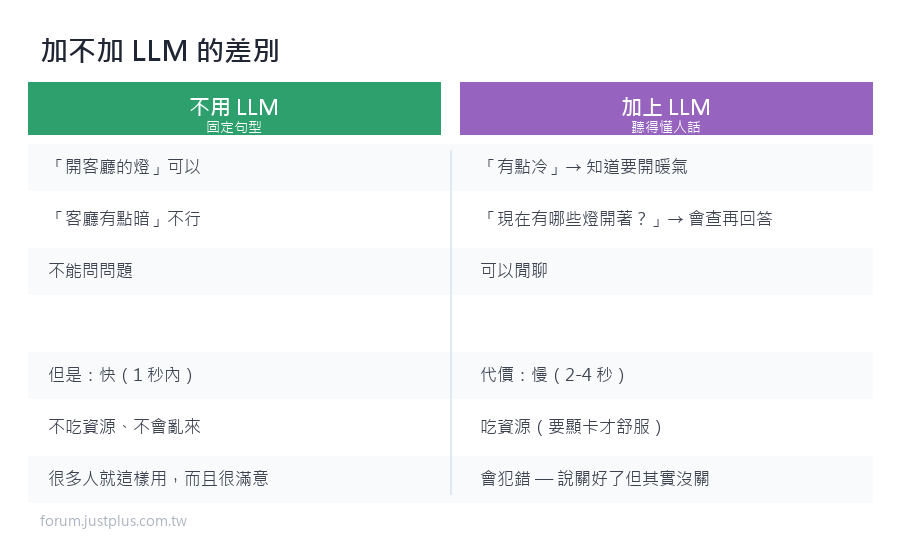
    為什麼要加 LLM

    沒有 LLM


    • 只能講固定的句型
    • 「開客廳的燈」可以,「客廳有點暗」不行
    • 不能問問題


    有 LLM


    • 「有點冷」→ 它知道要開暖氣
    • 「家裡現在有哪些燈開著?」→ 它會查然後回答
    • 「等一下如果下雨記得提醒我關窗」→ 可以做到(要設定)


    但也有代價


    • (2-4 秒 vs 1 秒以內)
    • 吃資源
    • 會犯錯(下面詳談)


    安裝 Ollama

    Ollama 是跑本地大語言模型最簡單的工具。

    三種裝法


    • HA 附加元件 —— 最簡單,但跟 HA 搶資源
    • Docker 在另一台機器 —— 推薦
    • 直接裝在有顯卡的電腦上 —— 最快


    Docker 的裝法
    1. docker run -d \
    2.   --name ollama \
    3.   -p 11434:11434 \
    4.   -v ollama:/root/.ollama \
    5.   --restart unless-stopped \
    6.   ollama/ollama
    複製代碼

    有 NVIDIA 顯卡的話加 --gpus all

    然後下載模型
    1. docker exec -it ollama ollama pull qwen3:8b
    複製代碼

    在 HA 裡接上


    • 設定 → 裝置與服務 → 新增整合Ollama
    • http://你的IP:11434
    • 選模型


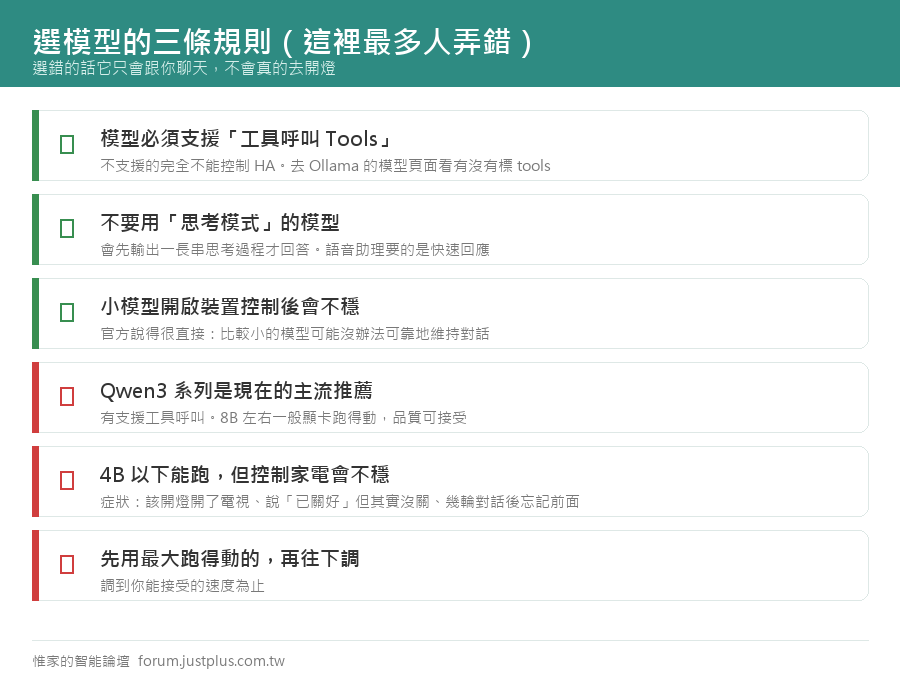
    選模型:這裡最多人弄錯

    規則一:模型必須支援「工具呼叫(Tools)」

    不支援 Tools 的模型完全不能控制 HA ——
    它只會跟你聊天,不會真的去開燈。

    怎麼確認:去 Ollama 的模型頁面看有沒有標 tools

    規則二:不要用「思考模式(think mode)」的模型

    那種模型會先輸出一長串思考過程再回答 ——
    語音助理要的是快速回應,不是深思熟慮。

    規則三:小模型會不穩

    官方的說法很直接

    比較小的模型,在開啟裝置控制之後,
    可能沒辦法可靠地維持對話。


    實際的症狀


    • 該開燈的時候開了電視
    • 回答「好的,已經幫你關燈了」但其實沒關
    • 對話幾輪之後忘記前面講什麼


    推薦的起點

    Qwen3 系列有支援工具呼叫,是現在的主流推薦。


    • 8B 左右 —— 一般顯卡跑得動,品質可接受
    • 更大的更準,但要更多顯存
    • 4B 以下 —— 能跑但控制家電會不穩


    建議做法先用最大跑得動的試,再往下調到可接受的速度。


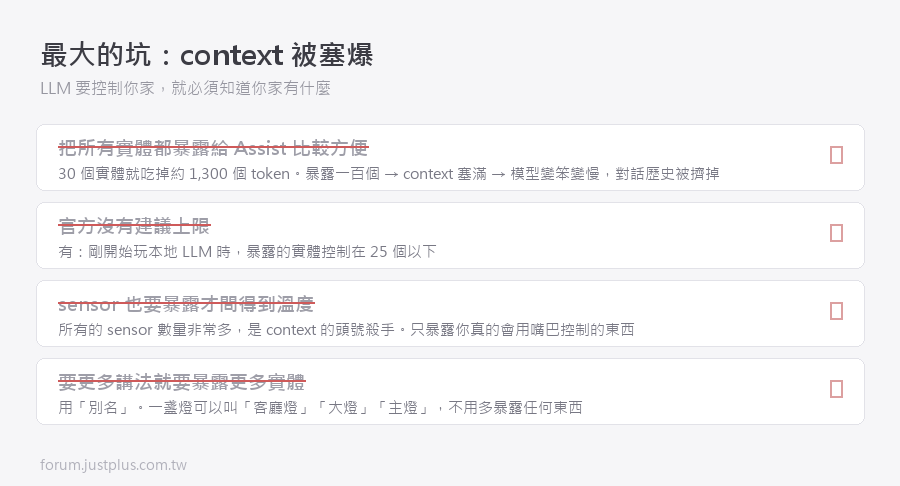
    最大的坑:context 被塞爆

    這個一定要懂。

    LLM 要控制你家,就必須知道你家有什麼 ——
    HA 會把「暴露給 Assist 的實體清單」全部塞進提示詞裡。

    數字很殘酷

    30 個實體大概就要吃掉 1,300 個 token 的 context。

    後果


    • 暴露一百個實體 → context 塞滿 → 模型變笨、變慢
    • 對話歷史被擠掉 → 它忘記你上一句講什麼
    • 小模型的 context 本來就不大,更容易爆


    官方的建議很明確

    剛開始玩本地 LLM 的時候,暴露的實體控制在 25 個以下。

    怎麼控制暴露的實體


    • 設定 → 語音助理公開 分頁
    • 預設可能全部都開著 —— 去關掉大部分


    該暴露的


    • 你真的會用語音控制的燈
    • 冷氣、風扇
    • 常用的開關


    不該暴露的


    • 所有的 sensor(溫度、濕度、電量……數量很多)
    • 診斷類的實體
    • 你不會用嘴巴控制的東西


    實用技巧:用「別名」代替暴露一堆

    一盞燈可以有好幾個叫法


    • 設定 → 語音助理 → 公開 → 點那個實體
    • 加別名:「客廳燈」「大燈」「主燈」


    這樣不用暴露更多實體,就能有更多講法。


    Ollama 對話代理的設定

    在整合的設定裡可以調


    • 指令(Instructions) —— 系統提示詞
    • Context 視窗大小
    • 最多保留幾則對話歷史
    • Keep-alive 時間


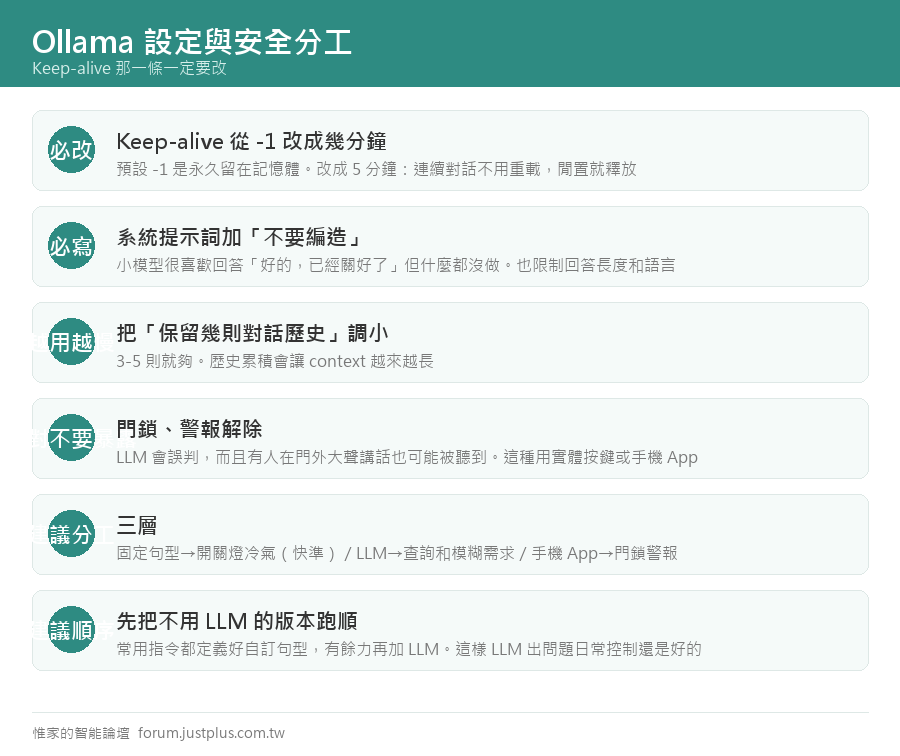
    Keep-alive 一定要改

    預設是 -1(永久留在記憶體)。

    後果模型會一直佔著系統記憶體不放

    建議改成幾分鐘


    • 5 分鐘 —— 連續對話不用重載,閒置就釋放
    • 設太短的話每次都要重新載入模型(第一句會很慢)


    指令(系統提示詞)的實用寫法
    1. 你是一個智慧家庭助理,用繁體中文回答。
    2. 規則:
    3. - 回答要短,一到兩句話
    4. - 不確定的時候直接說不確定,不要猜
    5. - 使用者要你控制裝置時,一定要真的呼叫工具
    6. - 不要編造裝置狀態,一定要查
    7. - 講到溫度用攝氏
    複製代碼

    「不要編造」這條很重要 ——
    小模型很喜歡回答「好的,已經關好了」但其實什麼都沒做。

    LLM 會怎麼出錯(實際的例子)

    一、幻覺式的回報

    症狀:說「已經關燈」但燈還亮著。

    對策


    • 用比較大的模型
    • 在系統提示詞裡強調
    • 重要的動作不要交給 LLM(用固定句型)


    二、開錯裝置

    症狀:說「開房間燈」結果開了客廳。

    對策


    • 實體名稱不要太像
    • 減少暴露的實體
    • 用別名讓叫法更明確


    三、對話跑題

    症狀:問天氣它開始講哲學。

    對策系統提示詞限制它的角色和回答長度

    四、越用越慢

    症狀:前幾句很快,後面越來越慢。

    原因對話歷史累積,context 越來越長

    對策把「最多保留幾則對話歷史」調小(3-5 則就夠)。

    安全上的考量

    不要暴露這些給 LLM


    • 門鎖(真的不要)
    • 警報系統的解除
    • 任何有安全後果的東西


    理由


    • LLM 會誤判
    • 有人在你家門外大聲講話也可能被聽到
    • 這種東西用實體按鍵或手機 App 就好


    一個合理的分工
    1. 語音 + 固定句型   →  開關燈、冷氣、風扇(快、準)
    2. 語音 + LLM         →  查詢、模糊的需求、閒聊
    3. 手機 App / 實體鍵  →  門鎖、警報、任何重要的東西
    複製代碼

    LLM 是加分項,不是取代。

    完全不用 LLM 也可以嗎

    可以,而且很多人這樣用。


    • HA 內建的意圖辨識 + 自訂句型
    • 速度快、不吃資源、不會亂來
    • 缺點是只能講你定義過的句子


    我的建議


    • 先把不用 LLM 的版本跑順
    • 常用的指令都定義好自訂句型
    • 有餘力再加 LLM 處理「其他情況」


    這樣就算 LLM 出問題,日常控制還是好的。

    ---

    下一篇:能源監控 ——
    從一顆智能插座開始,到整戶用電分析。
    您需要登入後纔可以回帖 登入 | 立即註冊

    本版積分規則

    Archiver|手機版|惟家的智能論壇

    GMT+8, 2026-9-24 12:19 , Processed in 0.085394 second(s), 26 queries .

    快速回覆 返回頂部 返回列表